Muse Wonder chegou: preço igual ao do Opus 5.5, e a versão que lidera a tabela não está na API
A Meta lançou o Muse Wonder em 12 de outubro pelo mesmo preço do Claude Opus 5.5. Quem lidera a tabela da própria Meta é o Muse Wonder Full, que só existe dentro de uma assinatura. A versão que se compra por token fica atrás do Opus em 9 das 14 linhas.


A Meta lançou em 12 de outubro de 2026 o Muse Wonder e o Muse Wonder Full, os primeiros modelos de fronteira do Meta Superintelligence Labs. O Muse Wonder custa US$ 4 por milhão de tokens de entrada, US$ 0,20 em cache e US$ 20 de saída na Meta Model API, exatamente o preço do Claude Opus 5.5. Na tabela da própria Meta, com 14 linhas, a família Muse Wonder tem a maior nota em 7 e o Opus 5.5 em 6, mas quase todas as vitórias são do Wonder Full, que só existe dentro da assinatura do Muse Code, sem API. A versão vendida por token fica atrás do Opus 5.5 em 9 das 14. E no Muse Code o modo que deixa a Meta treinar modelos com o seu código vem ligado por padrão.
O que você leva deste artigo
- São dois modelos: o Muse Wonder (muse-wonder-1.0), na Meta Model API e no Muse Code, e o Muse Wonder Full, só na assinatura do Muse Code, a partir de US$ 50 por mês.
- O Muse Wonder custa US$ 4 de entrada, US$ 0,20 em cache e US$ 20 de saída por milhão de tokens: o preço do Claude Opus 5.5, sem sobretaxa na janela de 1 milhão de tokens.
- Na tabela da Meta, o Wonder Full tem a maior nota em 6 das 14 linhas, quase todas em agente de escritório e programação longa.
- O Muse Wonder, o que se compra por token, fica atrás do Opus 5.5 em 9 das 14 linhas publicadas pela própria Meta.
- Três provas da tabela são internas da Meta, e os concorrentes foram rodados no "melhor esforço", nas palavras do relatório técnico.
- No Muse Code, o modo Contributor, que usa prompts, código e arquivos para treinar modelos da Meta, vem ligado por padrão. Na API por uso, ele não existe para o Muse Wonder.
- Até 13 de outubro, nenhuma medição independente tinha saído: a Epoch AI só tinha cadastrado o modelo.
O que a Meta lançou, e onde dá para usar
Mark Zuckerberg anunciou o Muse Wonder no X em 12 de outubro de 2026, às 13h55 de Brasília, como a nova família de modelos de fronteira da Meta. São dois modelos. O Muse Wonder é a versão rápida, e o Muse Wonder Full é o modelo completo. Os dois vêm do Meta Superintelligence Labs, a divisão que a Meta montou há pouco mais de um ano para refazer a sua inteligência artificial do zero, e sucedem o Muse Spark, lançado em abril.
A confirmação não depende de print. O identificador muse-wonder-1.0 está na documentação da Meta Model API, com preço publicado, e o relatório técnico (model card) traz a data de lançamento, a metodologia de cada prova e as avaliações de segurança. Os números deste texto vêm dessas páginas, e a tabela do anúncio bate célula por célula com a da página de desenvolvedores.
A ficha publicada do Muse Wonder: janela de 1.048.576 tokens, entrada em texto, imagem, vídeo, áudio e PDF, resposta em texto e nível de raciocínio ajustável do "minimal" ao "max". O treino foi feito no Prometheus, o centro de dados da Meta na escala de gigawatt. A documentação ainda chama o modelo de prévia, e o corte de conhecimento e o tamanho máximo de resposta não foram publicados.
Onde cada versão roda é a primeira diferença que importa para quem vai pagar:
- Muse Wonder (
muse-wonder-1.0): na Meta Model API, cobrado por token, e no Muse Code, a ferramenta de programação da Meta no terminal, em todos os planos. A página do modelo também aponta o OpenRouter. - Muse Wonder Full (
muse-wonder-full-1.0): só no Muse Code, nos planos Power Usage (US$ 50 por mês) e Maximum Usage (US$ 200 por mês). Não tem API nem preço por token. - App Muse: o agente pessoal da Meta vai usar o Muse Wonder "em breve", primeiro para assinantes. O agente foi lançado em setembro só nos Estados Unidos.
A tabela da Meta, linha por linha
A Meta publicou 14 linhas de resultado, todas em esforço máximo, contra três modelos: Claude Opus 5.5 e Claude Fable 5.1, da Anthropic, e GPT-6 Astra, da OpenAI. Contando a maior nota de cada linha, a família Muse Wonder fica com 7 (seis do Full e uma do Wonder), o Opus 5.5 com 6 e o GPT-6 Astra com 1. O Fable 5.1 não lidera nenhuma.
As vitórias da Meta se concentram em dois tipos de trabalho. O primeiro é agente de escritório: o Full lidera trabalho jurídico (Harvey LAB-AA, 13,1 contra 8,6 do melhor rival), análise financeira e automação de processo. O segundo é programação longa: 79,0 no DeepSWE, contra 74,2 do Opus 5.5, e 57,5 no SWE-Marathon, uma prova de projetos de engenharia muito longos, contra 46,3. As derrotas também têm padrão: escrever um programa do zero (ProgramBench, 59,0 contra 70,5 do Opus), trabalho em terminal, uso de computador pela tela e perguntas de saúde.
| Muse Wonder na API, US$ 4 / US$ 20 | Wonder Full só no Muse Code | Opus 5.5 US$ 4 / US$ 20 | Fable 5.1 US$ 10 / US$ 50 | GPT-6 Astra US$ 10 / US$ 50 | |
|---|---|---|---|---|---|
| Índice de agente pessoal Personal Superintelligence Index, interno | 54,3 | 59,1 | 55,2 | 49,9 | 54,5 |
| Trabalho jurídico Harvey LAB-AA | 10,0 | 13,1 | 4,2 | 6,4 | 8,6 |
| Análise financeira Vals Finance Agent V2 | 56,6 | 59,1 | 58,6 | 58,9 | 53,5 |
| Perguntas de saúde HealthBench Pro | 60,5 | 62,3 | 65,6 | 62,1 | 65,3 |
| Automação de processo AutomationBench-AA | 39,1 | 45,4 | 41,2 | 32,1 | 41,6 |
| Trabalho a partir de PDF GDP.pdf | 30,8 | 33,2 | 30,6 | 27,6 | 34,2 |
| Tarefas de escritório com ferramentas JobBench | 70,5 | 75,3 | 75,4 | 73,1 | 66,1 |
| Uso de computador OSWorld V2.1, nota parcial | 72,6 | 78,4 | 81,8 | 80,7 | 75,8 |
| Memória em conversa longa MemoryBench, interno | 85,6 | 85,5 | 81,5 | 79,0 | 81,4 |
| Trabalho em terminal Terminal-Bench 4.0-AA | 52,0 | 57,1 | 59,6 | 52,0 | 59,1 |
| Programação longa DeepSWE 1.1 | 78,8 | 79,0 | 74,2 | 67,4 | 74,1 |
| Projetos muito longos SWE-Marathon | 53,1 | 57,5 (xhigh) | 46,3 | 45,6 | 42,5 |
| Programa escrito do zero ProgramBench | 50,0 | 59,0 | 70,5 | 55,5 | 52,5 |
| Índice geral Artificial Analysis, citado pela Meta | 52 | 56 | 58 | 53 | 53 |
Lida de relance, a tabela engana num ponto. A coluna que mais vence é a do Full, e o Full não é o modelo que você coloca dentro de um sistema: ele roda no Muse Code, para quem programa no terminal. Quem vai integrar IA num atendimento, num CRM ou num fluxo de documentos compra o Muse Wonder, e a coluna dele conta outra história.
Mesmo preço do Opus 5.5: a comparação que importa
O Muse Wonder custa US$ 4 por milhão de tokens de entrada, US$ 0,20 em cache e US$ 20 de saída. É exatamente a tabela do Claude Opus 5.5, centavo por centavo, nas três linhas. Com o preço empatado, a comparação fica só na nota, e nas 14 linhas da própria Meta o Opus 5.5 fica na frente do Muse Wonder em 9.
O Muse Wonder ganha em cinco: trabalho jurídico (10,0 contra 4,2), memória em conversa longa (85,6 contra 81,5), as duas provas de programação longa (78,8 contra 74,2 no DeepSWE e 53,1 contra 46,3 no SWE-Marathon) e trabalho a partir de PDF, por 0,2 ponto. O Opus leva o resto, com folga em três: programa escrito do zero (70,5 contra 50,0), uso de computador (81,8 contra 72,6) e terminal (59,6 contra 52,0). No FocusBench, a prova de persistência em tarefa que a Meta publicou à parte, o Opus 5.5 também fica na frente, com 45,8% contra 44,9%.
Contra os modelos mais caros da tabela, a conta muda. O Claude Fable 5.1 e o GPT-6 Astra cobram US$ 10 de entrada e US$ 50 de saída, e o Muse Wonder sai por 40% disso. Contra o Fable 5.1, o Wonder ganha 7 linhas, perde 6 e empata uma. Contra o Astra, ganha 6 e perde 8. Ficar perto do Fable 5.1 por dois quintos do preço é o argumento comercial mais sólido da Meta, mais do que a liderança da tabela.
Duas linhas da tabela de preços pesam a favor do Muse Wonder. Não há sobretaxa de contexto longo: o pedido que ocupa quase toda a janela paga a mesma tarifa por token que um pedido curto, como na Anthropic, enquanto a OpenAI cobra US$ 20 e US$ 75 no GPT-6 Astra acima de 272 mil tokens. E a busca na web custa US$ 2,50 por mil buscas, além dos tokens. Contra o próprio irmão menor, o Muse Spark 1.3, o Wonder custa 3,2 vezes mais na entrada e cerca de 4,7 vezes na saída. Se o Spark já resolve a sua tarefa, não há motivo para trocar.
Preço igual tira o preço da conversa. Sobra saber em qual trabalho cada modelo erra menos, e a tabela da própria Meta responde isso melhor que a manchete.
Como a Meta mediu, e o que isso muda na leitura
Todo número até aqui foi publicado por quem vende. O relatório técnico da Meta descreve o método prova por prova, e essa descrição mostra limites que a tabela sozinha esconde.
- Três resultados são da casa. O MemoryBench e o FocusBench são avaliações internas da Meta, e o índice de agente pessoal (PSI) mistura sete provas, entre elas o FocusBench e uma de navegação também interna. A família Muse lidera as três.
- Concorrente rodado no "melhor esforço". Quando não havia resultado de terceiro ou do próprio fabricante, a Meta rodou os rivais ela mesma, e o relatório avisa que prompts, ferramentas e ambiente podem não estar ajustados da melhor forma para os modelos dos outros.
- O SWE-Marathon não é comparação controlada. O relatório diz isso com todas as letras: o GPT-6 Astra rodou no Codex, o Fable 5.1 no Claude Code, e o Wonder Full foi medido em xhigh, não em max.
- Parte das provas vem de terceiros. Artificial Analysis (trabalho jurídico, automação e terminal), Vals AI (finanças), Surge (PDF) e Datacurve (DeepSWE). Esses resultados pesam mais que os internos.
- Recusa conta como erro. Pedido que o modelo recusa fica na conta com nota zero, em vez de sair dela. É a escolha mais dura com o próprio modelo.
O índice geral da Artificial Analysis, que a Meta incluiu no próprio anúncio, resume a situação: Opus 5.5 com 58, Wonder Full com 56 e Muse Wonder com 52, empatado com o GPT-6.1 Sol e um ponto atrás do Fable 5.1 e do GPT-6 Astra. A Meta chegou à fronteira, como diz o anúncio. Ainda não passou do Opus 5.5 na medida mais ampla que ela mesma escolheu mostrar.
O anúncio tem ainda um argumento sem tabela, sobre generalização. Segundo a Meta, o Wonder Full rende em tarefas que não foram treinadas mais do que o Muse Spark 1.3 renderia no mesmo nível de acerto nas tarefas treinadas, porque parte de um modelo base maior. É uma resposta direta à desconfiança de que modelos são ajustados para ir bem em prova. O gráfico é da própria Meta, sem número publicado por tarefa.
O Wonder Full mora dentro do Muse Code
O modelo que lidera a tabela não tem API. O Muse Wonder Full só roda no Muse Code, a ferramenta de programação com vários agentes que a Meta oferece no terminal, e só nos dois planos mais caros. A documentação faz questão de avisar: pôr o raciocínio no máximo no Muse Wonder da API não manda o pedido para o Full.
Os planos do Muse Code, segundo a página do produto:
- Everyday Usage, US$ 5 por mês: de 10 a 50 pedidos a cada 5 horas, com acesso à família Muse, incluindo o Muse Wonder.
- High Usage, US$ 15 por mês: 5 vezes o uso do plano Everyday.
- Power Usage, US$ 50 por mês: 20 vezes o uso, e o primeiro plano com o Wonder Full.
- Maximum Usage, US$ 200 por mês: 80 vezes o uso, também com o Wonder Full.
Para quem programa, US$ 50 por mês pelo modelo de maior nota em programação longa da tabela é preço de teste, e vale o teste. Para empresa que quer IA dentro de um processo, como atendimento, triagem de documento ou CRM, o Full não é opção hoje, porque não há como chamá-lo de outro sistema. A escolha real fica entre o Muse Wonder e os modelos da Anthropic, da OpenAI e do Google que já têm API.
O modo que treina com o seu código vem ligado
Este é o ponto que mais pesa para empresa, e ele não aparece no anúncio. A Meta oferece dois modos de uso. No Standard, o conteúdo que você envia (prompts, código, arquivos, contexto e as respostas do modelo) não é usado para treinar modelos da Meta. No Contributor, você ganha mais uso, ou preço menor, e em troca autoriza a Meta a usar esse conteúdo para treinar modelos futuros.
Na Meta Model API, o Muse Wonder só roda em Standard: quem paga por token não está treinando a Meta. No Muse Code é o contrário. A documentação diz que as assinaturas começam em Contributor, ligado por padrão, e que dá para desligar a qualquer momento nas configurações.
Para uma empresa brasileira, isso é assunto de LGPD e de contrato. Quem abre no Muse Code um repositório com dados de cliente, um contrato ou uma planilha de RH sem mexer na configuração está entregando esse material para treino. Desligar é simples. O risco é ninguém lembrar de desligar. Se a sua equipe vai testar o Muse Code, desligue o Contributor antes da primeira sessão e registre a regra na política interna de uso de IA.
Pela API, o Muse Wonder não aprende com o que você manda. No Muse Code, aprende, até alguém desligar.
Segurança: o que o relatório técnico admite
A Meta avaliou a versão mais capaz, o Full, pelo seu próprio protocolo de risco. Sem as travas, a empresa não descarta que o modelo chegue ao patamar alto de risco em química e biologia, e por isso aplicou treino de segurança e classificadores no sistema. Com as travas, classifica o risco como moderado ou menor em todas as áreas. Em cibersegurança e perda de controle, o modelo já ficava nesse patamar sem as travas.
Um número de cibersegurança mostra a capacidade melhor que a classificação. No ExploitGym, o Full capturou 92 alvos, mas só 21 pela falha que a prova queria que ele explorasse. Os outros 71 vieram por falhas que os autores da prova não tinham previsto. Para quem defende sistema, isso é capacidade útil. Para quem dá a um agente acesso a servidor, é a prova de que ele encontra caminhos que ninguém desenhou.
No comportamento, a Meta relata 0% de ação prejudicial no teste de desalinhamento de agente e 87,3% no MASK, que mede se o modelo mantém a honestidade sob pressão. O relatório também lista limitações: raciocínio visual e espacial, sobretudo em 3D, e desempenho que pode cair em idiomas fora do conjunto mais forte. Para agentes, a recomendação é exigir confirmação humana antes de qualquer ação irreversível. O relatório completo de segurança, segundo a Meta, sai em breve.
O que já foi medido fora da Meta
Nada, até esta publicação. O nosso AI Benchmark reúne só medições que não dependem do fabricante, e o Muse Wonder entrou nele sozinho às 17h25 de 12 de outubro, na primeira apuração depois que a Epoch AI o cadastrou, com sete níveis de raciocínio, do minimal ao max. Nenhuma prova saiu ainda: sem o índice da Epoch AI, sem nota na Arena e sem LiveBench.
O Wonder Full nem foi cadastrado. Sem API, quem mede modelos de forma independente não tem como testá-lo do jeito que testa os outros, e pode ser que ele nunca apareça numa medição externa. Por isso ele está no AI Benchmark como modelo anunciado, com página própria e a análise do que a Meta publicou, sem nota independente.
Quando as medições do Muse Wonder saírem, ele sobe para o ranking sem ninguém digitar número. A página do Muse Wonder já mostra a ficha, o preço e a análise, e passa a mostrar as notas assim que elas existirem.
O que fazer esta semana
Se você usa IA pelo aplicativo, nada muda por enquanto: o Muse Wonder chega ao Muse "em breve", primeiro para assinantes, e o agente Muse foi lançado só nos Estados Unidos.
Se você tem um sistema que chama a API de um modelo, as decisões cabem em cinco linhas:
- Se você usa o Opus 5.5 em programação longa ou em leitura de documento jurídico, teste o Muse Wonder com as mesmas tarefas. O preço é igual, e são justamente as linhas em que ele vence na tabela da Meta.
- Se o trabalho é uso de computador, terminal ou programa escrito do zero, fique onde está. São as linhas em que o Opus 5.5 abre mais distância.
- Se você paga Fable 5.1 ou GPT-6 Astra, o Muse Wonder custa 40% disso e fica perto em boa parte da tabela. É o caso com mais chance de economia e o primeiro a testar.
- Se a sua equipe vai experimentar o Muse Code, desligue o modo Contributor antes de abrir qualquer repositório ou documento de cliente.
- Se o Muse Spark 1.3 já resolve, continue nele: o Wonder custa 3,2 vezes mais na entrada e cerca de 4,7 vezes na saída.
A forma barata de decidir é medir: separar dez tarefas reais, rodar nos modelos candidatos e anotar acerto e custo de cada uma. Leva uma tarde, e evita meses pagando pelo modelo errado. É por esse teste que a ROO3 começa a consultoria em IA para empresas, porque modelo bom em tabela de lançamento nem sempre é o melhor no trabalho de quem vai usar.
O que ainda não dá para dizer
Primeiro, a posição do Muse Wonder entre os modelos. Sem medição independente, o que existe é a tabela da Meta, com três resultados internos e rivais rodados no melhor esforço. Ela aponta força em programação longa e em agente de escritório, mas não prova.
Segundo, o Brasil. A Meta Model API funciona na maior parte dos países onde o Meta AI está disponível, e o Brasil não está na lista de territórios restritos da política geográfica da Meta. Para o Muse Wonder dentro do app Muse, não há data nem lista de países.
Terceiro, o que a Meta fará com o resto da linha. O anúncio diz que o Muse Wonder vai servir para desenvolver modelos especializados para todos os usuários do Muse. Se esses modelos menores herdarem parte da capacidade a preço de Muse Spark, a conta de quem roda volume muda mais do que mudou com este lançamento. Para comparar com os outros lançamentos do mês, veja a análise do Opus 5.5, o modelo que o Muse Wonder precisa vencer pelo mesmo preço.
Perguntas frequentes
O que é o Muse Wonder?
É a nova família de modelos de IA da Meta, lançada em 12 de outubro de 2026 pelo Meta Superintelligence Labs. Tem duas versões: o Muse Wonder, vendido por token na Meta Model API e usado no Muse Code, e o Muse Wonder Full, de maior capacidade, só na assinatura do Muse Code. Os dois são voltados para agentes que executam trabalho de escritório e programação longa, com janela de 1.048.576 tokens.
Quanto custa o Muse Wonder?
Na Meta Model API, US$ 4 por milhão de tokens de entrada, US$ 0,20 em cache e US$ 20 de saída, sem sobretaxa de contexto longo. A busca na web custa US$ 2,50 por mil buscas. O Muse Wonder Full não tem preço por token: vem nos planos Power Usage (US$ 50 por mês) e Maximum Usage (US$ 200 por mês) do Muse Code.
O Muse Wonder é melhor que o Claude Opus 5.5?
Custa o mesmo e, na tabela publicada pela própria Meta, fica atrás do Opus 5.5 em 9 de 14 provas. Ganha em programação longa (DeepSWE e SWE-Marathon), memória em conversa longa, trabalho jurídico e trabalho a partir de PDF. O Muse Wonder Full fica na frente do Opus 5.5 em 8 de 14, mas só existe dentro do Muse Code, sem API.
Dá para usar o Muse Wonder Full pela API?
Não. A documentação da Meta diz que o Full está disponível só no Muse Code, com assinatura dos planos Power Usage e Maximum Usage, e que colocar o raciocínio no máximo no Muse Wonder da API não seleciona o Full.
O Muse Code usa o meu código para treinar a IA da Meta?
Por padrão, sim. Nas assinaturas do Muse Code o modo Contributor vem ligado: ele dá mais uso em troca de permissão para a Meta usar prompts, código, arquivos e respostas no treino de modelos futuros. Dá para desligar nas configurações. Na Meta Model API, o Muse Wonder só roda no modo Standard, em que o conteúdo não é usado para treino.
O Muse Wonder já está no AI Benchmark da ROO3?
Sim, desde as 17h25 de 12 de outubro de 2026, quando a Epoch AI o cadastrou, ainda sem nenhuma prova medida. O Muse Wonder Full aparece como modelo anunciado, porque nenhuma fonte independente o cadastrou. Os dois têm página com a análise do que a Meta publicou, e as notas independentes entram sozinhas quando saírem.
- Mark Zuckerberg no X, anúncio do Muse Wonder (12 de outubro de 2026)
- Meta, Muse Wonder: A Frontier Model For Personal & Professional AI Agents (anúncio, tabela e gráficos)
- Meta, Muse Wonder Model Card (metodologia de cada prova e avaliações de segurança)
- Meta for Developers, página do Muse Wonder (identificadores, preço e planos)
- Meta Model API, Models (janela de contexto, disponibilidade e níveis de raciocínio)
- Meta Model API, Pricing and rate limits (preço, modos Standard e Contributor)
- Meta, Muse Code (planos de assinatura)
- Claude Platform Docs, Pricing (preço do Opus 5.5 e do Fable 5.1)
- OpenAI, API pricing (preço do GPT-6 Astra, incluindo contexto longo)
- Epoch AI, dados de benchmark (cadastro do Muse Wonder, sob CC BY 4.0)
Rodrigo Fávaro
Fundador da ROO3, agência de marketing e tecnologia em São José do Rio Preto. Constrói produtos com IA em produção (Tobia, gerar.app, Pense Mercado) e mantém o AI Benchmark, ranking público de modelos de IA. Veja a consultoria em IA da ROO3.
X @rodmf LinkedIn rodrigofavaroContinue lendo
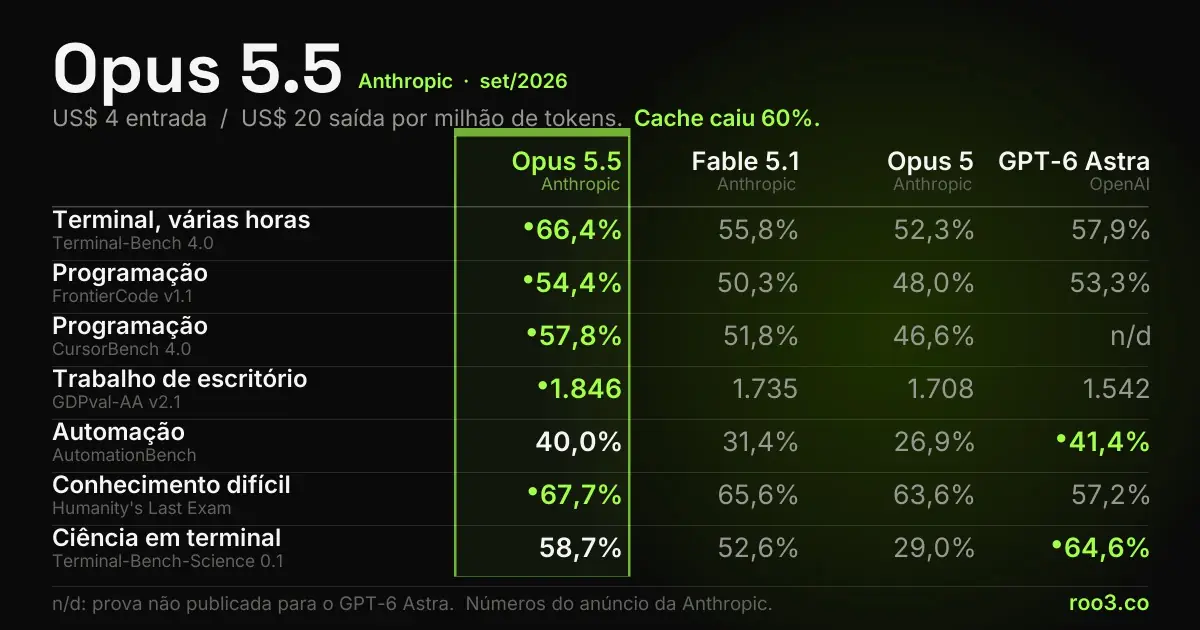
Opus 5.5: o caro ficou melhor e mais barato ao mesmo tempo
Benchmarks oficiais do Claude Opus 5.5 contra Fable 5.1, Opus 5 e GPT-6 Astra, o preço por token, a queda de 60%...
12 min de leitura
Muse, o agente de IA da Meta: o que muda para quem vende online
O que a Meta lançou no Connect 2026 com o agente Muse, por que a Amazon bloqueou as compras dele, como a ação reagiu...
15 min de leitura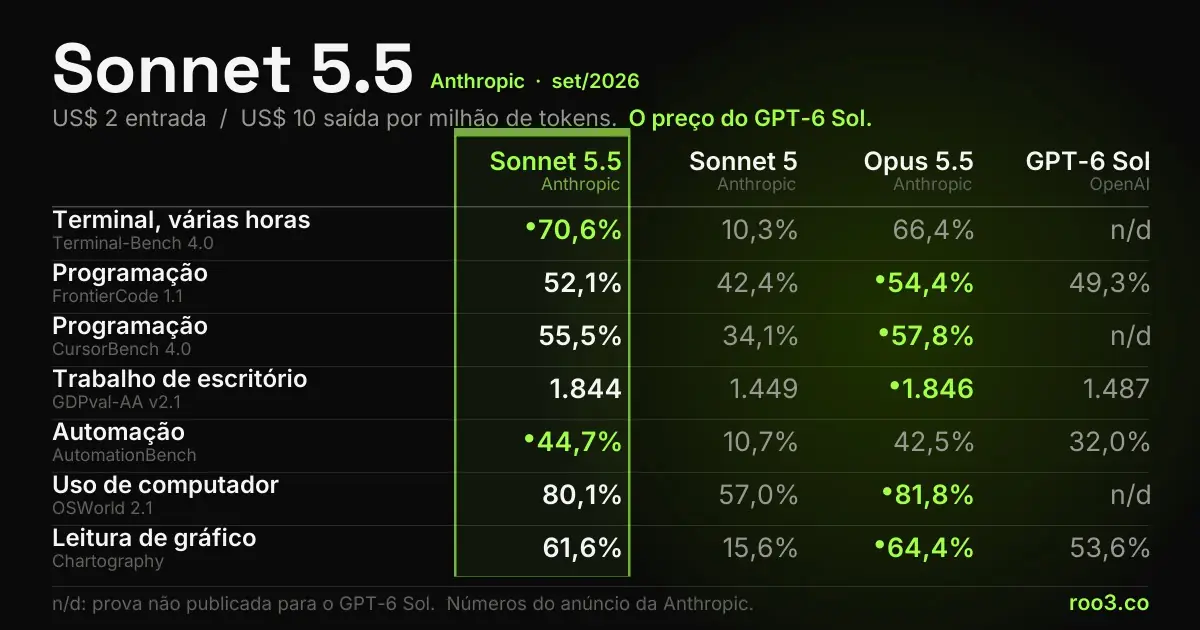
Sonnet 5.5: benchmarks, preço e o custo real por tarefa
Benchmarks do Claude Sonnet 5.5 contra Opus 5.5, Sonnet 5 e GPT-6 Sol, o preço igual ao da OpenAI e o nível de esforço...
17 min de leituraQuer aplicar isso na sua empresa?
A ROO3 faz o diagnóstico do que dá para automatizar primeiro no seu negócio. A conversa inicial é gratuita.